Desarrollo de inteligencia artificial para procesar y analizar el vasto archivo de datos de la Luna
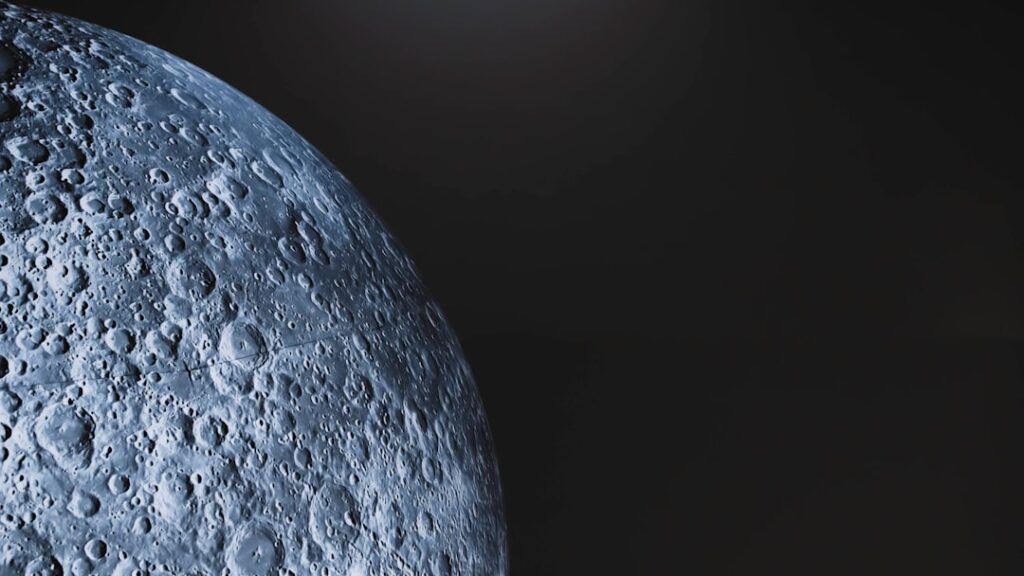
La colaboración entre la NASA, IBM e instituciones académicas ha creado un modelo fundacional de inteligencia artificial diseñado para procesar y extraer patrones complejos del enorme volumen de datos acumulados sobre la superficie lunar, mejorando las capacidades de la ciencia planetaria.
La Luna ha sido objeto de un estudio continuo durante al menos 17 años, principalmente a través de la misión Lunar Reconnaissance Orbiter (LRO), la cual ha generado un archivo de información sin precedentes sobre la geografía y topografía del satélite. Este acervo de datos es tan vasto que la agencia espacial estadounidense afirma que supera el volumen de información generado por todas sus demás misiones planetarias combinadas. Actualmente, el desafío de la comunidad científica no reside únicamente en la mera recolección de datos, sino en la capacidad de procesar este material con suficiente rapidez para identificar patrones útiles, un aspecto de mayor importancia a medida que la NASA planifica el regreso de tripulaciones humanas a la superficie lunar.
Para abordar esta complejidad, se desarrolló el NASA-IBM Lunar Foundation Model. Esta herramienta de inteligencia artificial ha sido publicada bajo código abierto, permitiendo su adaptación a una variedad de tareas específicas en el campo de la ciencia lunar, desde la cartografía detallada de cráteres hasta el estudio de estructuras volcánicas y regiones polares. El propósito del modelo no es reemplazar el análisis científico, sino optimizar la fase de trabajo que, mediante los métodos de análisis tradicionales, requiere el desarrollo y entrenamiento de sistemas especializados para cada tarea individual.
El poder del modelo reside en su proceso de entrenamiento. Este tipo de sistema fundacional aprende patrones generales a partir de cantidades masivas de información sin que sea necesario que cada imagen o dato de entrada esté etiquetado para un propósito concreto. Específicamente, el sistema procesó cerca de dos millones de teselas de información. Esta base de datos se nutre principalmente de la LRO, incluyendo más de un millón de imágenes de alta resolución (con un píxel aproximado de un metro) y casi 964.000 observaciones multiespectrales (con una separación de unos 100 metros por píxel). Además de estos datos, su entrenamiento incorporó material de otras misiones lunares, como GRAIL, Lunar Prospector y la nave japonesa Kaguya.
Una de las aplicaciones más destacadas del modelo se centra en las regiones polares. Estas áreas presentan la posibilidad de mantener hielo en la sombra durante miles de millones de años.
Fuentes: Xataka
Foto de Ammar ElAmir en Unsplash